用 Python 做一个学生成绩管理系统(班级统计篇)
一、背景
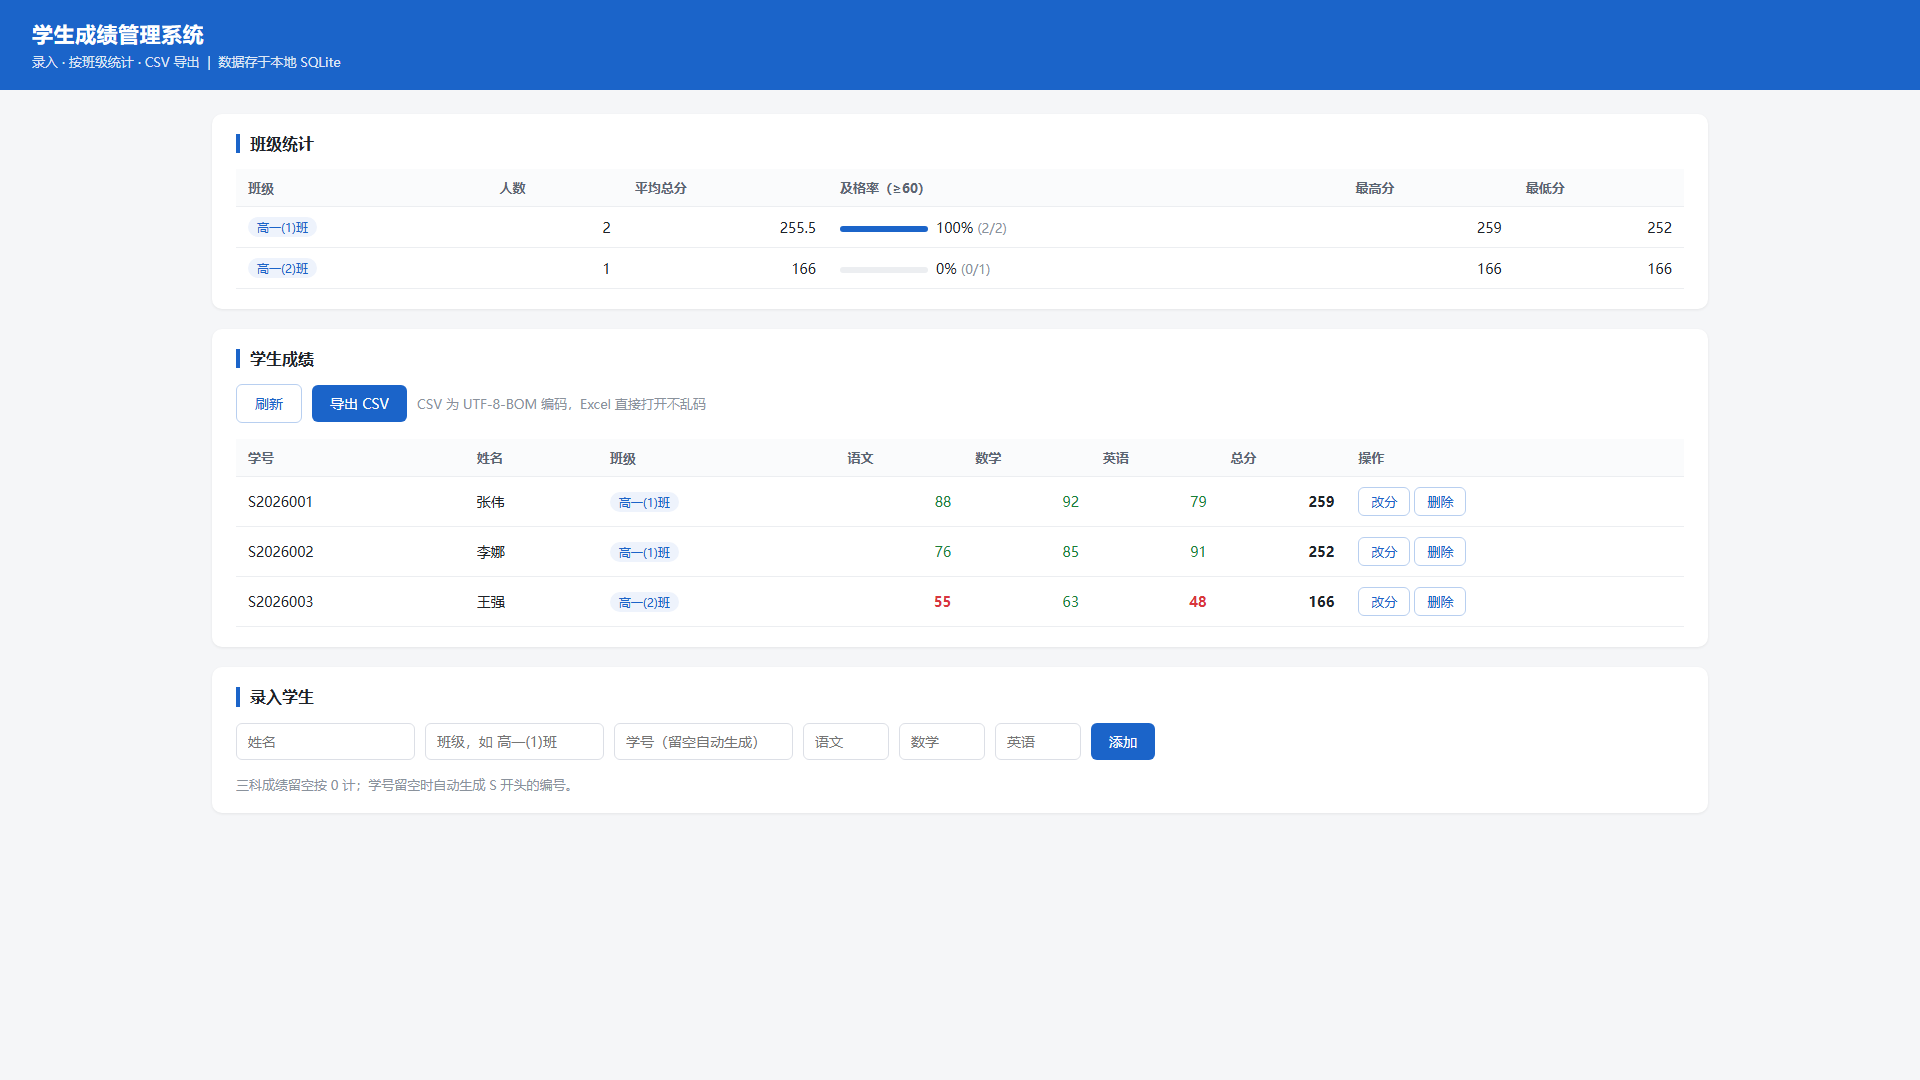
需求是从一个很具体的场景来的:年级主任要给班主任看各班成绩,班主任要在考完后补录几个缺考学生的成绩,教务处要拿一份能直接丢进 Excel 的表格。
把它拆成可执行的三件事:
1. **录入**:姓名、班级、学号、三科分数;学号可以自动生成。
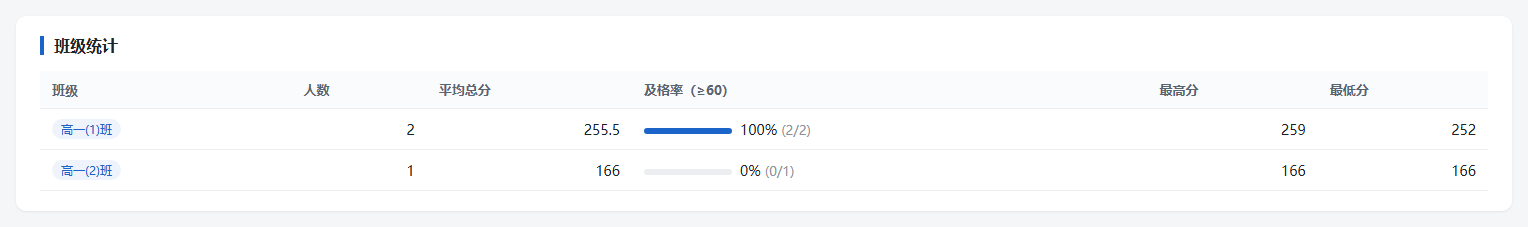
2. **统计**:按班级算人数、平均分、及格率(≥60 分)、最高分、最低分。
3. **导出**:给一份 CSV,教务处双击用 Excel 打开不能乱码。
技术上想得很简单:不要 Django,不要 Flask,不要前端构建。Python 自带 `http.server` 能起 HTTP 服务,`sqlite3` 能存数据,`csv` 能导出,够用了。整个系统只有 `app.py` 一个文件,`python app.py` 就能跑。
这里有个设计上的取舍值得先说:**数据量小,但结构不能将就**。很多人做这种小系统会把班级名直接写成学生表里的一个字符串字段,一开始能跑,等班级改名、或者要统计班级本身的属性(比如年级、班主任)就开始难受。所以下面直接用三张表。
二、表设计
三张表,各管一件事:
CREATE TABLE IF NOT EXISTS classes (
    id      INTEGER PRIMARY KEY AUTOINCREMENT,
    name    TEXT    NOT NULL UNIQUE,
    grade   TEXT    NOT NULL DEFAULT ''
);

CREATE TABLE IF NOT EXISTS students (
    id         INTEGER PRIMARY KEY AUTOINCREMENT,
    name       TEXT    NOT NULL,
    sno        TEXT    NOT NULL UNIQUE,
    class_id   INTEGER NOT NULL,
    FOREIGN KEY (class_id) REFERENCES classes(id)
);

CREATE TABLE IF NOT EXISTS scores (
    student_id INTEGER PRIMARY KEY,
    chinese    REAL    NOT NULL DEFAULT 0,
    math       REAL    NOT NULL DEFAULT 0,
    english    REAL    NOT NULL DEFAULT 0,
    FOREIGN KEY (student_id) REFERENCES students(id)
);
**为什么这么拆:**
- `classes` 存班级本身(名字、年级)。班级改名时只改这一行,不用扫学生表。
- `students` 只存「人」和「这个人属于哪个班」,不存成绩。一个人转班只是改 `class_id`。
- `scores` 单独一张,主键就是 `student_id`。将来要加物理、化学,加列就行,不用动学生表;缺考的学生可以暂时没有成绩行,用 `LEFT JOIN` 出来是 0 分。
拆开的代价是查询要 JOIN,但这恰恰是 SQL 擅长的事:
SELECT c.name                                            AS klass,
       COUNT(s.id)                                       AS cnt,
       AVG(sc.chinese + sc.math + sc.english)            AS avg_total,
       MAX(sc.chinese + sc.math + sc.english)            AS max_total,
       MIN(sc.chinese + sc.math + sc.english)            AS min_total,
       SUM(CASE WHEN sc.chinese >= 60 AND sc.math >= 60 AND sc.english >= 60
                THEN 1 ELSE 0 END)                       AS passed
  FROM classes  c
  LEFT JOIN students s  ON s.class_id = c.id
  LEFT JOIN scores   sc ON sc.student_id = s.id
 GROUP BY c.id, c.name
 ORDER BY c.name
这段话是整个系统的核心:**平均分、及格率、最高最低分,全部在一次查询里算完**,没有把数据捞到 Python 里循环。
三、关键实现
1. 统计用 SQL 聚合,不在 Python 里循环
最初我是先把学生列表捞出来,在 Python 里 `sum()` 和 `len()` 的。问题是修改一条成绩后,页面上的统计要么忘记重算、要么重算了但顺序错。改成 SQL 聚合之后,每次请求 `/api/stats` 都直接问数据库,天然不会过期:
def class_stats():
    conn = get_conn()
    try:
        rows = conn.execute(
            """
            SELECT c.name AS klass, COUNT(s.id) AS cnt,
                   AVG(sc.chinese + sc.math + sc.english) AS avg_total,
                   SUM(CASE WHEN sc.chinese >= ? AND sc.math >= ? AND sc.english >= ?
                            THEN 1 ELSE 0 END) AS passed
              FROM classes  c
              LEFT JOIN students s  ON s.class_id = c.id
              LEFT JOIN scores   sc ON sc.student_id = s.id
             GROUP BY c.id, c.name
            """,
            (PASS_SCORE, PASS_SCORE, PASS_SCORE),
        ).fetchall()
`LEFT JOIN` 而不是 `INNER JOIN` 是刻意的:新建成还没录成绩的班级也要出现在统计里(人数 0),不能因为没成绩就整班消失。
2. 及格率要防除零
`SUM(...) / COUNT(*)` 在班级人数为 0 时会抛异常。所以除之前先判:
cnt = r["cnt"] or 0
passed = r["passed"] or 0
"pass_rate": round(passed * 100.0 / cnt, 1) if cnt else 0.0
这个 `if cnt else 0.0` 不是防御性编程的洁癖——刚建完班、还没录入学生时刷新页面,就真的会走到这条分支。
3. 录入时班级不存在要自动建
三表结构下,录一个「高一(3)班」的学生时,`classes` 表里可能还没有这一行。直接插 `students` 会因为没有对应 `class_id` 而失败。所以录入函数里先查后建:
row = conn.execute("SELECT id FROM classes WHERE name=?", (klass,)).fetchone()
if row:
    class_id = row["id"]
else:
    cur_c = conn.execute(
        "INSERT INTO classes(name, grade) VALUES (?,?)",
        (klass, klass[:2] if len(klass) >= 2 else klass),
    )
    class_id = cur_c.lastrowid

cur = conn.execute(
    "INSERT INTO students(name, sno, class_id) VALUES (?,?,?)",
    (name, sno, class_id),
)
sid = cur.lastrowid
# 成绩单独写进 scores 表
conn.execute(
    "INSERT INTO scores(student_id, chinese, math, english) VALUES (?,?,?,?)",
    (sid, grades[0], grades[1], grades[2]),
)
注意这里是**两次 INSERT**,不是一次。三表拆开后写一条学生数据必然涉及两张表,所以必须放在同一个事务里——中途失败要能整体回滚,不能留下有学生没成绩的半条数据。
4. CSV 导出必须带 BOM
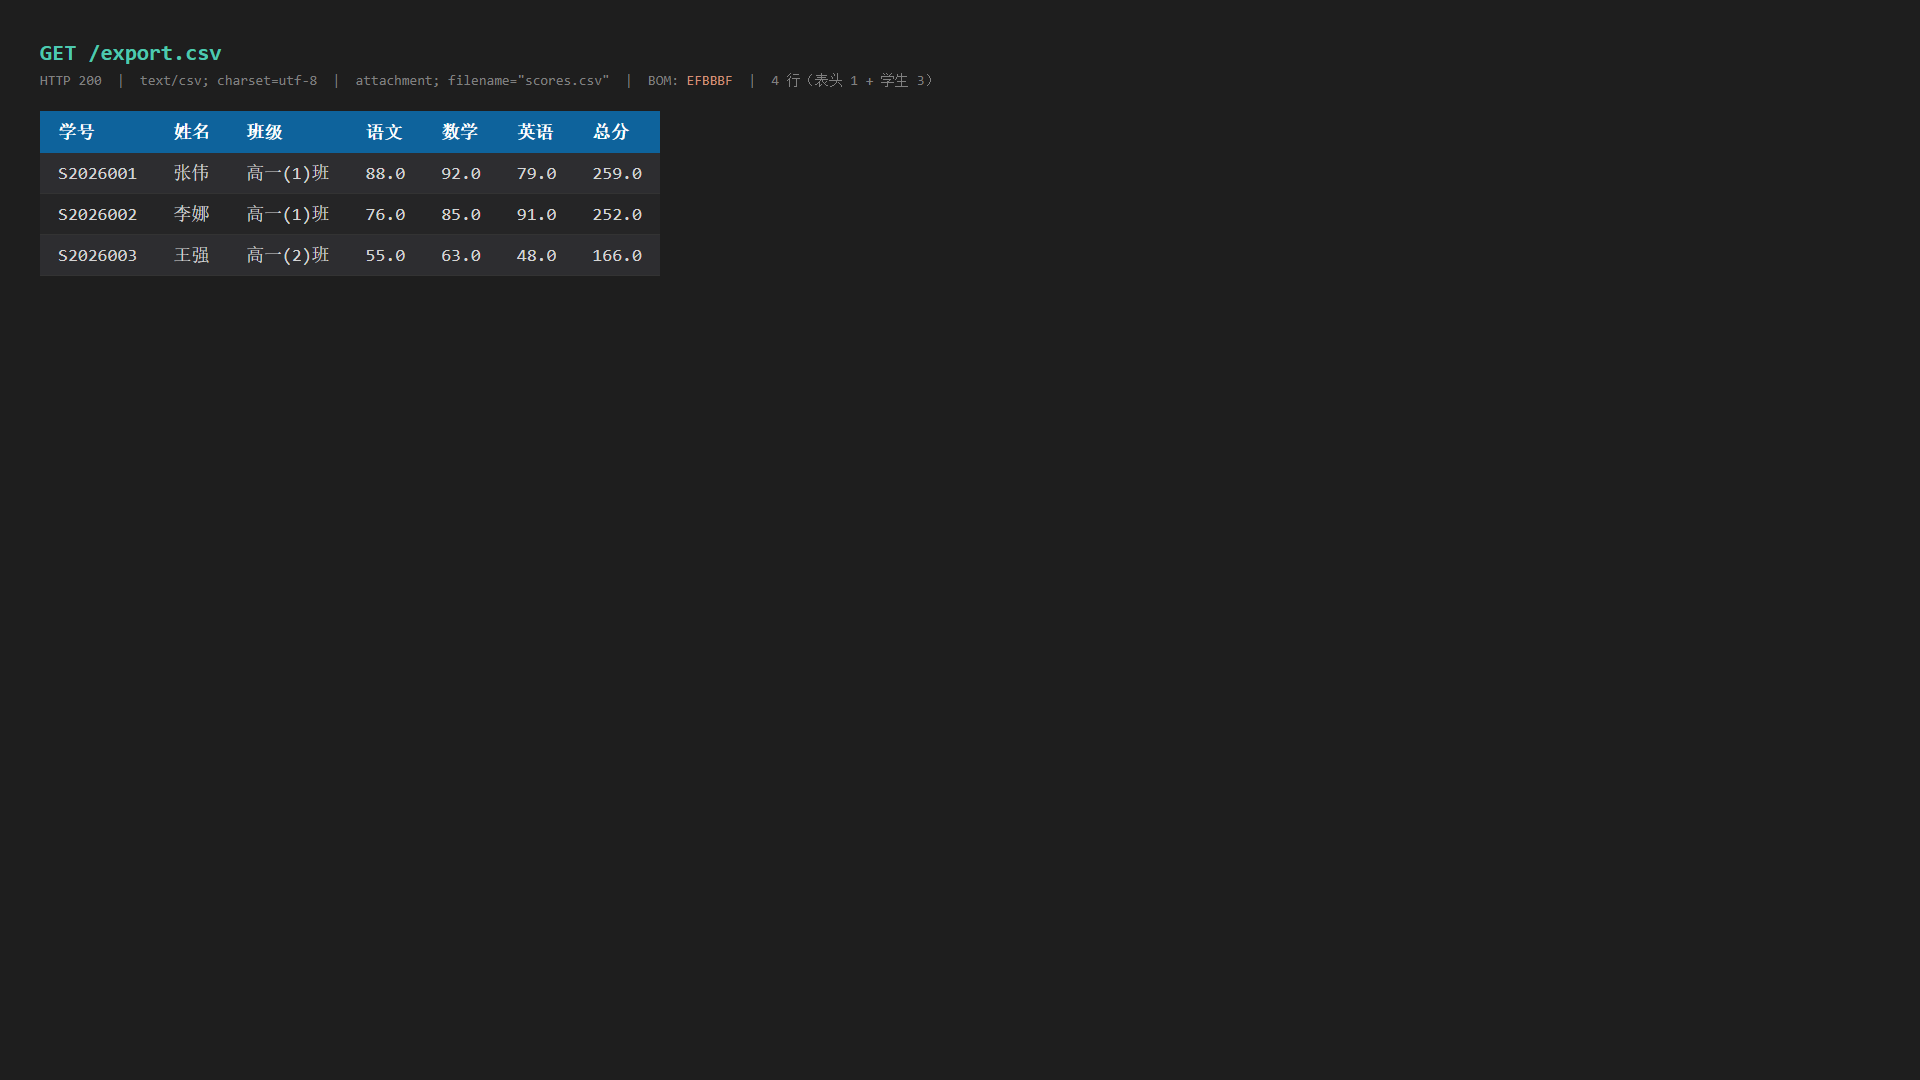
这是导出功能唯一的坑,也是最重要的一个:
def export_csv_bytes():
    buf = io.StringIO(newline="")
    w = csv.writer(buf)
    w.writerow(["学号", "姓名", "班级", "语文", "数学", "英语", "总分"])
    for s in list_students():
        w.writerow([s["sno"], s["name"], s["klass"],
                    s["chinese"], s["math"], s["english"], s["total"]])
    # utf-8-sig 会自动写入 BOM(EF BB BF)
    return buf.getvalue().encode("utf-8-sig")
关键是最后那行 `encode("utf-8-sig")`。用普通的 `utf-8` 编码,中文内容在 Excel 里打开就是一堆乱码——因为 Excel 不会去猜 UTF-8,它默认按本地代码页(中文 Windows 上是 GBK)解码。加上 BOM 之后,Excel 看到文件头 `EF BB BF` 就知道这是 UTF-8。
另外 `io.StringIO(newline="")` 里的 `newline=""` 也不能省,否则 `csv.writer` 写出来的每行会多一个空行。
5. 端口占用自动顺延
开发时经常忘了上次的服务还在跑,`Address already in use` 一报就得手动改端口。所以启动前先探测:
def pick_port(host, start, tries=20):
    for p in range(start, start + tries):
        if not port_in_use(host, p):
            return p
    raise RuntimeError("没有可用端口")

def port_in_use(host, port):
    with socket.socket(socket.AF_INET, socket.SOCK_STREAM) as s:
        s.settimeout(0.3)
        return s.connect_ex((host, port)) == 0
默认从 8100 起(避开产品自身占用的 8899),被占用就往后找 20 个。
6. 服务端校验,不只靠前端
前端把三科成绩的输入框都设成了 `type="number" min="0" max="100"`,但那只是体验,不是防线——`curl` 一个 POST 就能绕过。所以服务端照样校验:
for k in SUBJECTS:
    v = payload.get(k, 0)
    try:
        v = float(v)
    except (TypeError, ValueError):
        raise ValueError("%s 成绩必须是数字" % SUBJECT_LABELS[k])
    if v < 0 or v > 100:
        raise ValueError("%s 成绩需在 0-100 之间" % SUBJECT_LABELS[k])
这两道校验各有各的用途:前端拦住手滑,服务端拦住脚本。
四、踩过的坑
坑 1:CSV 中文全是乱码
第一版导出直接 `encode("utf-8")`,自己用文本编辑器打开完全正常,交给教务处用 Excel 一开全是 `å¼ ä¼Ÿ` 这种。折腾了半天以为是内容有问题,其实是 Excel 根本没按 UTF-8 解码。
改成 `utf-8-sig` 后正常。验证方法是看文件前三个字节:
body[:3] == b"\xef\xbb\xbf" # True 才算带上 BOM这个坑的教训是:**「我这儿能打开」不等于「用户那儿能打开」**。
坑 2:统计数字看起来对,其实是过期的
早期版本统计是在页面加载时算一次,存成全局变量。改完分数点保存,表格里的分数变了,但上面的及格率还是老的——因为统计函数没被重新调用。用户看到的就是「改了分但及格率没变」,会以为保存失败。
修法是干脆不缓存:`/api/stats` 每次请求都现场查库聚合。数据量这么小,多查一次的开销远小于数据不一致带来的困扰。
坑 3:`AVG` 遇到 NULL 会把整行吞掉
`AVG(sc.chinese + sc.math + sc.english)` 里只要有一个是 `NULL`,整个加法表达式就是 `NULL`,`AVG` 会直接跳过这一行——不报错,只是悄悄少算一个人。
现象是:班级 3 个人,平均分却像是按 2 个人算的。最后定位到是某条记录的成绩列是 `NULL`(早期建表时没写 `DEFAULT 0`)。
两个修法都做了:建表时给三科都加 `NOT NULL DEFAULT 0`;查询里用 `COALESCE(sc.chinese, 0)` 兜底。**聚合函数遇到 NULL 从来不报错,它只是默默算错**,这比抛异常难查得多。
坑 4:三表拆分后,改分改到了不存在的学生
改成三表结构后,改分接口从 `UPDATE students SET chinese=?` 变成了 `UPDATE scores SET chinese=? WHERE student_id=?`。测试时传了一个不存在的 id,接口居然返回 200 成功。
原因是代码里有个「成绩行不存在就先插入」的逻辑,它给一个根本不存在的 `student_id` 建了一行孤儿成绩,然后 `UPDATE` 自然就命中了一行、`rowcount == 1`、返回成功。
修法是**先查学生存不存在,再动成绩表**:
who = conn.execute("SELECT id FROM students WHERE id = ?", (sid,)).fetchone()
if who is None:
    raise ValueError("学生不存在:id=%s" % sid)
这个坑很典型的点在于:拆表之后,「操作成功」的判断依据变了。单表时代 `UPDATE students` 的 `rowcount` 天然能证明学生存在;拆表之后,`rowcount` 只证明「成绩表里有一行被改了」,跟学生存不存在没关系了。
坑 5:`Content-Length` 没写导致浏览器一直转圈
自定义 `BaseHTTPRequestHandler` 时,如果手动 `wfile.write(body)` 却不写 `Content-Length` 头,浏览器会一直等待连接关闭来判断内容结束,表现为页面卡在加载中。`curl` 反而正常,因为它读到 EOF 就返回了。
所以每次响应都要显式写:
self.send_header("Content-Length", str(len(body)))这个坑只在浏览器里复现,光用 `curl` 测接口是发现不了的。
五、小结
这个系统总共 600 多行,零第三方依赖。回过头看,真正花时间的不是写功能,而是几个「看起来能跑」的细节:
- CSV 的 BOM——不加就是乱码,加了才对;
- SQL 聚合里的 NULL——不报错,只是算错;
- 拆表之后的 `rowcount`——它证明的东西和单表时代完全不是一回事;
- `Content-Length`——`curl` 能过但浏览器卡死。
关于表设计,一句话总结:**班级、学生、成绩是三件不同的事,就该是三张表**。合在一张表里能跑,但每次需求变化(改班级名、加科目、转班)都要改数据本身,那才是真正的技术债。
代码在 `app.py` 一个文件里,`python app.py` 启动,默认 8100 端口,首次运行自动建表并灌 3 条演示数据。数据库就是一个 `scores.db` 文件,删掉重启就是全新状态。
如果要把这个系统继续做下去,下一步大概是:加分科目配置表(现在三科是写死的列)、加成绩导入(现在只能一条条录)、加历史考试批次(现在只有当前成绩,没有「期中」「期末」的区分)。第三个尤其重要——真实场景下成绩一定是按考试批次存的,这也是表设计从三张变四张的地方。
六、运行截图
下面三张是同一套代码在本机跑出来的真实界面(演示数据,不是效果图)。